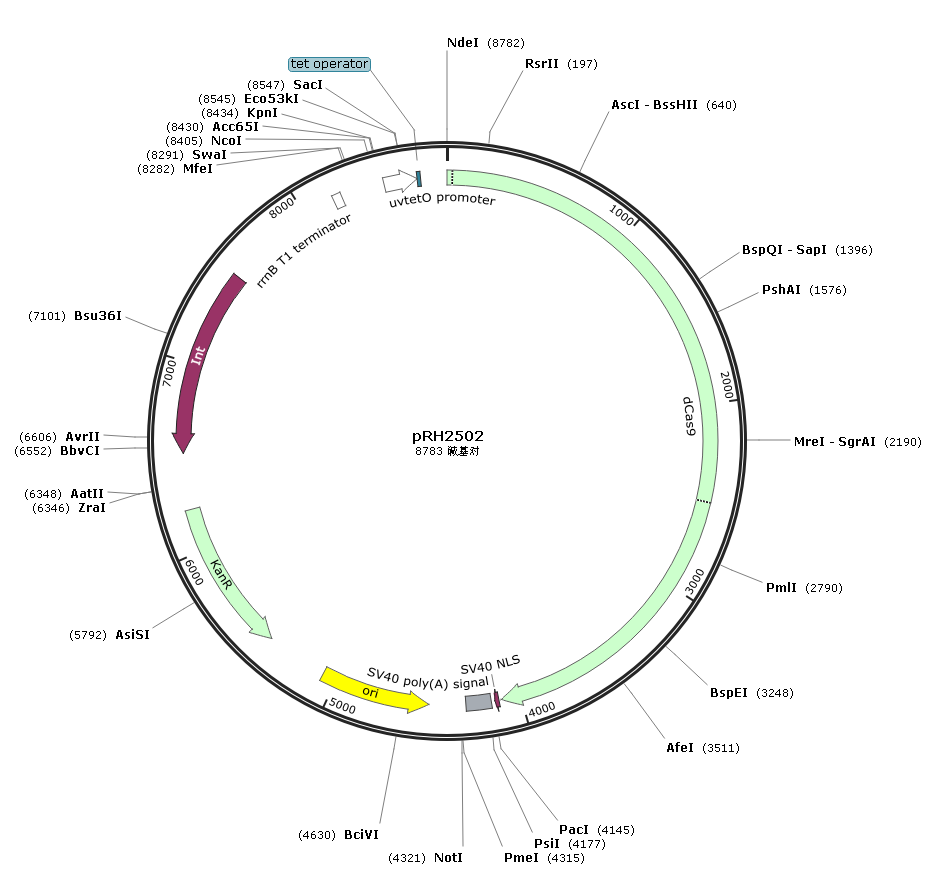
pRH2502
Price:
¥0
Copy Product Information
View Plasmid Sequence
Contact Us
Product Disclaimer
For Research Use Only research use only . They are not intended for clinical trials or for use in humans, including oral administration, injection, or therapeutic use in vivo or ex vivo.Plasmid Sequence and Experimental Performance reference/template plasmid . MiaoLing guarantees the accuracy of the specified gene sequence based on our sequencing results, but does not guarantee downstream experimental performance, including gene expression, transfection efficiency, protein expression, or other experimental outcomes.Sequence Verification of Certain Vector Products key functional regions has been confirmed to be correct, the product will be considered a correct and usable vector for research purposes.After-Sales Period for Small-Pack Plasmid Products three months from the date of receipt . Customers are advised to transform and process the plasmid promptly after receipt. After the three-month period, a new purchase may be required for further support or replacement.Research-Related Risks and Limitation of Liability Citation in Chinese Publications 产品名称(产品货号)由淼灵质粒平台提供。 Citation in English Publications “Product Name (Product Item Number) was obtained from MiaoLing Plasmid, China.”
质粒序列
View Plasmid Sequence
ATGGACAAGAAGTACAGCATCGGCCTGGCGATCGGCACGAACTCGGTGGGCTGGGCGGTCATCACGGACGAGTACAAGGTCCCCTCCAAGAAGTTCAAGGTCCTGGGCAACACCGACCGGCACAGCATCAAGAAGAACCTGATCGGCGCCCTGCTGTTCGACTCCGGCGAGACCGCCGAGGCGACGCGCCTGAAGCGGACCGCGCGGCGCCGATACACGCGGCGCAAGAACCGCATCTGCTACCTGCAGGAAATCTTCTCGAACGAGATGGCCAAGGTGGACGACAGCTTCTTCCACCGGCTGGAGGAGTCCTTCCTGGTGGAGGAGGACAAGAAGCACGAGCGCCACCCGATCTTCGGCAACATCGTGGACGAGGTGGCCTACCACGAGAAGTACCCCACGATCTACCACCTGCGCAAGAAGCTGGTGGACAGCACCGACAAGGCGGACCTGCGGCTGATCTACCTGGCCCTGGCGCACATGATCAAGTTCCGCGGCCACTTCCTGATCGAGGGCGACCTGAACCCGGACAACTCGGACGTGGACAAGCTGTTCATCCAGCTGGTGCAGACCTACAACCAGCTGTTCGAGGAGAACCCCATCAACGCCTCCGGCGTGGACGCCAAGGCGATCCTGTCGGCGCGCCTGTCCAAGTCGCGGCGCCTGGAGAACCTGATCGCCCAGCTGCCGGGCGAGAAGAAGAACGGCCTGTTCGGCAACCTGATCGCGCTGAGCCTGGGCCTGACGCCCAACTTCAAGTCCAACTTCGACCTGGCCGAGGACGCGAAGCTGCAGCTGTCGAAGGACACCTACGACGACGACCTGGACAACCTGCTGGCCCAGATCGGCGACCAGTACGCGGACCTGTTCCTGGCCGCCAAGAACCTGAGCGACGCCATCCTGCTGTCCGACATCCTGCGGGTCAACACCGAGATCACGAAGGCCCCGCTGAGCGCGTCCATGATCAAGCGGTACGACGAGCACCACCAGGACCTGACCCTGCTGAAGGCGCTGGTGCGCCAGCAGCTGCCCGAGAAGTACAAGGAAATCTTCTTCGACCAGTCGAAGAACGGCTACGCCGGCTACATCGACGGCGGCGCGAGCCAGGAGGAGTTCTACAAGTTCATCAAGCCGATCCTGGAGAAGATGGACGGCACGGAGGAGCTGCTGGTCAAGCTGAACCGCGAGGACCTGCTGCGCAAGCAGCGGACCTTCGACAACGGCTCGATCCCGCACCAGATCCACCTGGGCGAGCTGCACGCCATCCTGCGGCGCCAGGAGGACTTCTACCCCTTCCTGAAGGACAACCGCGAGAAGATCGAGAAGATCCTGACCTTCCGCATCCCGTACTACGTGGGCCCCCTGGCCCGCGGCAACTCGCGGTTCGCGTGGATGACCCGGAAGAGCGAGGAGACCATCACGCCGTGGAACTTCGAGGAGGTCGTGGACAAGGGCGCCTCGGCGCAGAGCTTCATCGAGCGCATGACCAACTTCGACAAGAACCTGCCGAACGAGAAGGTCCTGCCCAAGCACAGCCTGCTGTACGAGTACTTCACCGTGTACAACGAGCTGACGAAGGTCAAGTACGTGACCGAGGGCATGCGGAAGCCGGCCTTCCTGTCGGGCGAGCAGAAGAAGGCGATCGTGGACCTGCTGTTCAAGACCAACCGCAAGGTCACGGTGAAGCAGCTGAAGGAGGACTACTTCAAGAAGATCGAGTGTTTCGACTCGGTCGAGATCAGCGGCGTGGAGGACCGCTTCAACGCCAGCCTGGGCACCTACCACGACCTGCTGAAGATCATCAAGGACAAGGACTTCCTGGACAACGAGGAGAACGAGGACATCCTGGAGGACATCGTCCTGACCCTGACGCTGTTCGAGGACCGCGAGATGATCGAGGAGCGGCTGAAGACGTACGCCCACCTGTTCGACGACAAGGTGATGAAGCAGCTGAAGCGGCGCCGATACACCGGCTGGGGCCGCCTGTCGCGGAAGCTGATCAACGGCATCCGGGACAAGCAGTCCGGCAAGACCATCCTGGACTTCCTGAAGTCGGACGGCTTCGCGAACCGCAACTTCATGCAGCTGATCCACGACGACAGCCTGACCTTCAAGGAGGACATCCAGAAGGCCCAAGTGAGCGGCCAGGGCGACTCCCTGCACGAGCACATCGCCAACCTGGCGGGCTCGCCGGCGATCAAGAAGGGCATCCTGCAGACCGTCAAGGTCGTGGACGAGCTGGTCAAGGTGATGGGCCGCCACAAGCCCGAGAACATCGTGATCGAGATGGCCCGGGAGAACCAGACCACGCAGAAGGGCCAGAAGAACAGCCGCGAGCGGATGAAGCGCATCGAGGAGGGCATCAAGGAGCTGGGCTCGCAGATCCTGAAGGAGCACCCGGTCGAGAACACCCAGCTGCAGAACGAGAAGCTGTACCTGTACTACCTGCAGAACGGCCGCGACATGTACGTGGACCAGGAGCTGGACATCAACCGGCTGAGCGACTACGACGTGGACGCCATCGTGCCGCAGTCGTTCCTGAAGGACGACAGCATCGACAACAAGGTCCTGACCCGCTCGGACAAGAACCGGGGCAAGTCGGACAACGTGCCCAGCGAGGAGGTCGTGAAGAAGATGAAGAACTACTGGCGCCAGCTGCTGAACGCCAAGCTGATCACGCAGCGCAAGTTCGACAACCTGACCAAGGCCGAGCGGGGCGGCCTGAGCGAGCTGGACAAGGCGGGCTTCATCAAGCGCCAGCTGGTCGAGACCCGGCAGATCACGAAGCACGTGGCGCAGATCCTGGACTCGCGGATGAACACGAAGTACGACGAGAACGACAAGCTGATCCGCGAGGTCAAGGTGATCACCCTGAAGTCCAAGCTGGTCTCGGACTTCCGCAAGGACTTCCAGTTCTACAAGGTCCGGGAGATCAACAACTACCACCACGCCCACGACGCGTACCTGAACGCCGTCGTGGGCACCGCGCTGATCAAGAAGTACCCGAAGCTGGAGTCGGAGTTCGTCTACGGCGACTACAAGGTCTACGACGTGCGCAAGATGATCGCCAAGAGCGAGCAGGAGATCGGCAAGGCCACCGCGAAGTACTTCTTCTACTCCAACATCATGAACTTCTTCAAGACCGAGATCACGCTGGCCAACGGCGAGATCCGCAAGCGCCCGCTGATCGAGACCAACGGCGAGACGGGCGAGATCGTCTGGGACAAGGGCCGCGACTTCGCGACCGTCCGGAAGGTGCTGAGCATGCCGCAGGTCAACATCGTGAAGAAGACCGAGGTGCAGACGGGCGGCTTCTCCAAGGAGTCGATCCTGCCCAAGCGCAACTCGGACAAGCTGATCGCCCGGAAGAAGGACTGGGACCCGAAGAAGTACGGCGGCTTCGACTCCCCCACCGTCGCCTACTCGGTGCTGGTCGTGGCGAAGGTCGAGAAGGGCAAGTCCAAGAAGCTGAAGTCGGTGAAGGAGCTGCTGGGCATCACCATCATGGAGCGCTCGTCGTTCGAGAAGAACCCGATCGACTTCCTGGAGGCGAAGGGCTACAAGGAGGTCAAGAAGGACCTGATCATCAAGCTGCCCAAGTACAGCCTGTTCGAGCTGGAGAACGGCCGCAAGCGGATGCTGGCCTCCGCGGGCGAGCTGCAGAAGGGCAACGAGCTGGCCCTGCCGTCGAAGTACGTCAACTTCCTGTACCTGGCGTCGCACTACGAGAAGCTGAAGGGCAGCCCCGAGGACAACGAGCAGAAGCAGCTGTTCGTGGAGCAGCACAAGCACTACCTGGACGAGATCATCGAGCAGATCAGCGAGTTCTCCAAGCGGGTCATCCTGGCCGACGCGAACCTGGACAAGGTGCTGTCGGCCTACAACAAGCACCGCGACAAGCCGATCCGGGAGCAGGCGGAGAACATCATCCACCTGTTCACCCTGACGAACCTGGGCGCCCCCGCCGCGTTCAAGTACTTCGACACCACGATCGACCGCAAGCGGTACACCTCCACGAAGGAGGTGCTGGACGCGACCCTGATCCACCAGTCGATCACCGGCCTGTACGAGACGCGCATCGACCTGAGCCAGCTGGGCGGCGACTCCCGGGCGGACCCGAAGAAGAAGCGGAAGGTGTGATTAATTAACAAACTCGGAACTTGTTTATTGCAGCTTATAATGGTTACAAATAAAGCAATAGCATCACAAATTTCACAAATAAAGCATTTTTTTCACTGCATTCTAGTTGTGGTTTGTCCAAACTCATCAATGTATCTTATCATGTCTGGATCCTCTAGAGTCGACCTGCAGGTTTAAACGCGGCCGCACGCGTTGCGCTCGGTCGTTCGGCTGCGGCGAGCGGTATCAGCTCACTCAAAGGCGGTAATACGGTTATCCACAGAATCAGGGGATAACGCAGGAAAGAACATGTGAGCAAAAGGCCAGCAAAAGGCCAGGAACCGTAAAAAGGCCGCGTTGCTGGCGTTTTTCCATAGGCTCCGCCCCCCTGACGAGCATCACAAAAATCGACGCTCAAGTCAGAGGTGGCGAAACCCGACAGGACTATAAAGATACCAGGCGTTTCCCCCTGGAAGCTCCCTCGTGCGCTCTCCTGTTCCGACCCTGCCGCTTACCGGATACCTGTCCGCCTTTCTCCCCTCGGGAAGCGTGGCGCTTTCTCATAGCTCACGCTGTAGGTATCTCAGTTCGGTGTAGGTCGTTCGCTCCAAGCTGGGCTGTGTGCACGAACCCCCCGTTCAGCCCGACCGCTGCGCCTTATCCGGTAACTATCGTCTTGAGTCCAACCCGGTAAGACACGACTTATCGCCACTGGCAGCAGCCACTGGTAACAGGATTAGCAGAGCGAGGTATGTAGGCGGTGCTACAGAGTTCTTGAAGTGGTGGCCTAACTACGGCTACACTAGAAGGACAGTATTTGGTATCTGCGCTCTGCTGAAGCCAGTTACCTTCGGAAAAAGAGTTGGTAGCTCTTGATCCGGCAAACAAACCACCGCTGGTAGCGGTGGTTTTTTTGTTTGCAAGCAGCAGATTACGCGCAGAAAAAAAGGATCTCAAGAAGATCCTTTGATCTTTTCTACGGGGTCTGACGCTCATGGAACTAGTGAGGTCTGCCTCGTGAAGAAGGTGTTGCTGACTCATACCAGGCCTGAATCGCCCCATCATCCAGCCAGAAAGTGAGGGAGCCACGGTTGGTGAGAGCTTTGTTGTAGGTGGACCAGTTGGTGATTTTGAACTTTTGCTTTGCCACGGAACGGTCTGCGTTGTCGGGAAGATGCGTGATCTGATCCTTCAACTCAGCAAAAGTTCGATTTATTCAACAAAGCCGCCGTCCCGTCAAGTCAGCGTAATGCTCTGCCAGTGTTACAACCAATTAACCAATTCTGATTAGAAAAACTCATCGAGCATCAAATGAAACTGCAATTTATTCATATCAGGATTATCAATACCATATTTTTGAAAAAGCCGTTTCTGTAATGAAGGAGAAAACTCACCGAGGCAGTTCCATAGGATGGCAAGATCCTGGTATCGGTCTGCGATTCCGACTCGTCCAACATCAATACAACCTATTAATTTCCCCTCGTCAAAAATAAGGTTATCAAGTGAGAAATCACCATGAGTGACGACTGAATCCGGTGAGAATGGCAAAAGATTATGCATTTCTTTCCAGACTTGTTCAACAGGCCAGCCATTACGCTCGTCATCAAAATCACTCGCATCAACCAAACCGTTATTCATTCGTGATTGCGCCTGAGCGAGACGAAATACGCGATCGCTGTTAAAAGGACAATTACAAACAGGAATCGAATGCAACCGGCGCAGGAACACTGCCAGCGCATCAACAATATTTTCACCTGAATCAGGATATTCTTCTAATACCTGGAATGCTGTTTTCCCGGGGATCGCAGTGGTGAGTAACCATGCATCATCAGGAGTACGGATAAAATGCTTGATGGTCGGAAGAGGCATAAATTCCGTCAGCCAGTTTAGTCTGACCATCTCATCTGTAACATCATTGGCAACGCTACCTTTGCCATGTTTCAGAAACAACTCTGGCGCATGGGGCTTCCCATACAAGCGATAGATTGTCGCACCTGATTGCCCGACATTATCGCGAGCCCATTTATACCCATATAAATCAGCATCCATGTTGGAATTTAATCGCGGCCTCGAGCAAGACGTTTCCCGTTGAATATGGCTCATAACACCCCTTGTATTACTGTTTATGTAAGCAGACAGTTTTATTGTTCATGATGATATATTTTTATCTTGTGCAATGTAACATCAGAGATTTTGAGACACAACGTGGCTTTCCCCCCCCCCCGACGTCAGGTGGCTAGCTGGCGGGAACGGCAATGCTCCTGGCGGCGGCGGGGCTGGTGCCCAGGTCTCCGCACAGAGCGGCGGTGCTGGCGCTCGCGGCCAGGCGTGGTTCTTCGCGTACTGACAAGAAACCCCCCTCTTTAGGACTCAGTGTCCTTGGGAGGGGGGCTTTTTGCGTTTCAGGAGGTCTTGGCCAGCTTGGACATCGCCTCAGCGATAGCCTCGTCGCGGGCCTCAGACGCCATCTGGTACTTCATCGCCATCCTAGGAGTCGTGTGACCGAGACGGGCCATCAGCTCCTTGGTCGTCGCACCTGCCTGAGCGGCGAACGTAGCGCCGACAGCGCGGAGGTCGTGGATGCGGAGTTCCGGCCGACCGATCTTGGCGTAGCCACGCTTCAGCGACTTGGTGAACGCGGACTTCGACAGCCGGTTGCCCTGCGTCGTGGTCACCAGGAATGCCTCGGGGCCCTTGTTCATCTTCGTACGGTCCTTCATGTGCGCTCGGATCATCTCCGCGACGTGAGGCGGAACCGTCACAGGACGCTTCGACCGGACGGTCTTGGCGTTGCCAACGACGATCTTGTTCCCCACGCGGGAAGCGCCACGGCGCACCCGGAGCTTCATCGTCATGCCGTCGTCCACGATGTCCTTGCGGCGAAGCTCGATCAGCTCTCCGAACCGGAGGCTCGTCCACGCCAGGATGTATGCCGCGATCCGGTAGTGCACGAAGATCTCAGCGGCGACGATGTCCAGCTCCTCAGGCGTCAGCGCCTCTACGTCGCGCTCATCGGCTGCCTTCTGCTCGATCCGGCACGGGTTCTCTGCGATCAGCTTGTCCTCGACCGCTGTGTTCATCACCGCCCGGAGGACGTTGTAGGCATGCCGGCGGGCAGTCGGGTGCTTCCTACCCATCCCGGCCCACCACGCACGCACCAGAGCTGGCGTCATCTCTGTGACCGCCACTTCACCTAGCACCGGGTAGATGCGGCGCTCCGCGTGCCCGCTGTACAGATCCCTGGTGCCGTCTGCGAGGTCGCGCTCCACGAGCCACTTCCGGGTGTACTCCTCCAGCGTGATGGCGCTGGCGGCTGCCTTCTTCGCCCGGTCCTGTGGAGGGGTCCAGGTCTCCATCTCGATGAGCCGCTTCTCGCCCGCGAGCCAGGCTTCGGCGTCCATCTTGTTGTCGTAGGTCTGCAGCGCGTAGTACCTCACACCGTCCTGCGGGTTGACGTATGAGGCTTGGATCCTCCCGCTGCGCTGAGTCTTCAGCGATCCCCATCCGCGACGTGCCAACTAGGTCTCCTCTCGTCGTGAACAAGGCTACCGGGTTGCAACTCCTGTGCAACTCTCAGGCTTCAACGCGCTTCTACGACCTGCAATTTCTTTCCACTTAGAGGATGCAGCCGAGAGGGGGTAAAAACCTATCTTGACCGGCCCATATATGTGGTCGGCAGACACCCATTCTTCCAAACTAGCTACGCGGGTTCGATTCCCGTCGCCCGCTCCGCTGGTCAGAGGGTGTTTTCGCCCTCTGGCCATTTTTCTTTCCAGGGGTCTGCAACTCTTGTGCGACTCTTCTGACCTGGGCATACGCGGTTGCAACGCATCCCTGATCTGGCTACTTTCGATGCTGACAAACGAATAGAGCCCCCCGCCTGCGCGAACAGACGAGGGGCATTCACACCAGATTGGAGCTGGTGCAGTGAAGAGAATAGACCGGGACAAGGTTGCACCGGGAGTTGCAGCGGTCGGAACCCTCGCCGTCGGCGGGCTGGCGTTCGCCCTGTCGTTCACGGCTCTAGCTGATCACCGCGGCCATGATGGCATAAAACGAAAGGCCCAGTCTTTCGACTGAGCCTTTCGTTTTATTTGATGCCTGGCAGTCGATCGTACGCTAGTTAACTACGTCGACATCGATTTAATCGATCGATATGCATCAATTGATTTAAATACTAGTGTTAACTATTTAATTGGGGACCCTAGAGGTCCCCTTTTTTATTTTAAAAATTTTTTCAAGGGGACCTCTAGGGTCCCCAGCTGGCTAGCGAGTCATGAGGTCACCATGGTGGCCATCTAGACATCATCGGTACCAGGCCTAGATCTACTAGAAATATTGGATCGTCGGCACCGTCACGGCCGTGGGAGGCGGCACGATCCGCGACGTGATGATCGGCCGCATCCCCACGGTGCTGCGCAGTGAGCTCTACGCCATCCCGGCGTTGATCTGTGCGTTCGCACGCACAGGCCCGGTGTGAGAAGGGTCTCTGACGAGCGGGAGAACTCCCTATCAGTGATAGAGTTTGTCCTCCCTATCAGTGATAGATAGGCTCTGGGAGTACCCGTGTGTACGACCAGCACGGCATACATCATTTCGACGCCGAGAGATTCGCCGCCCGAAATGAGCACGATCCGCTCGAGGCATGCGAAGGAGATATACAT
Product Documents
No related files available.
Plasmid Elements
CDS 1..4104
/codon_start=1
/product="catalytically dead mutant of the Cas9
endonuclease from the Streptococcus pyogenes Type II
CRISPR/Cas system"
/note="RNA引导的DNA结合蛋白,由于RuvC催化结构域中的D10A突变和HNH催化结构域的H840A突变而缺乏内切酶活性"
/translation="MDKKYSIGLAIGTNSVGWAVITDEYKVPSKKFKVLGNTDRHSIKK
NLIGALLFDSGETAEATRLKRTARRRYTRRKNRICYLQEIFSNEMAKVDDSFFHRLEES
FLVEEDKKHERHPIFGNIVDEVAYHEKYPTIYHLRKKLVDSTDKADLRLIYLALAHMIK
FRGHFLIEGDLNPDNSDVDKLFIQLVQTYNQLFEENPINASGVDAKAILSARLSKSRRL
ENLIAQLPGEKKNGLFGNLIALSLGLTPNFKSNFDLAEDAKLQLSKDTYDDDLDNLLAQ
IGDQYADLFLAAKNLSDAILLSDILRVNTEITKAPLSASMIKRYDEHHQDLTLLKALVR
QQLPEKYKEIFFDQSKNGYAGYIDGGASQEEFYKFIKPILEKMDGTEELLVKLNREDLL
RKQRTFDNGSIPHQIHLGELHAILRRQEDFYPFLKDNREKIEKILTFRIPYYVGPLARG
NSRFAWMTRKSEETITPWNFEEVVDKGASAQSFIERMTNFDKNLPNEKVLPKHSLLYEY
FTVYNELTKVKYVTEGMRKPAFLSGEQKKAIVDLLFKTNRKVTVKQLKEDYFKKIECFD
SVEISGVEDRFNASLGTYHDLLKIIKDKDFLDNEENEDILEDIVLTLTLFEDREMIEER
LKTYAHLFDDKVMKQLKRRRYTGWGRLSRKLINGIRDKQSGKTILDFLKSDGFANRNFM
QLIHDDSLTFKEDIQKAQVSGQGDSLHEHIANLAGSPAIKKGILQTVKVVDELVKVMGR
HKPENIVIEMARENQTTQKGQKNSRERMKRIEEGIKELGSQILKEHPVENTQLQNEKLY
LYYLQNGRDMYVDQELDINRLSDYDVDAIVPQSFLKDDSIDNKVLTRSDKNRGKSDNVP
SEEVVKKMKNYWRQLLNAKLITQRKFDNLTKAERGGLSELDKAGFIKRQLVETRQITKH
VAQILDSRMNTKYDENDKLIREVKVITLKSKLVSDFRKDFQFYKVREINNYHHAHDAYL
NAVVGTALIKKYPKLESEFVYGDYKVYDVRKMIAKSEQEIGKATAKYFFYSNIMNFFKT
EITLANGEIRKRPLIETNGETGEIVWDKGRDFATVRKVLSMPQVNIVKKTEVQTGGFSK
ESILPKRNSDKLIARKKDWDPKKYGGFDSPTVAYSVLVVAKVEKGKSKKLKSVKELLGI
TIMERSSFEKNPIDFLEAKGYKEVKKDLIIKLPKYSLFELENGRKRMLASAGELQKGNE
LALPSKYVNFLYLASHYEKLKGSPEDNEQKQLFVEQHKHYLDEIIEQISEFSKRVILAD
ANLDKVLSAYNKHRDKPIREQAENIIHLFTLTNLGAPAAFKYFDTTIDRKRYTSTKEVL
DATLIHQSITGLYETRIDLSQLGGD"
SV40 NLS 4117..4137
/codon_start=1
/product="nuclear localization signal of SV40 large T
antigen"
/translation="PKKKRKV"
SV40 poly(A) signal 4158..4292
/note="SV40聚腺苷酸化信号"
ori complement(4488..5076)
/direction=LEFT
/note="高拷贝数ColE1/pMB1/pBR322/pUC复制起点"
KanR complement(5407..6222)
/codon_start=1
/gene="aph(3')-Ia"
/product="aminoglycoside phosphotransferase"
/note="赋予细菌对卡那霉素的抗性或真核生物对G418(遗传霉素(R))的抗性"
/translation="MSHIQRETSCSRPRLNSNMDADLYGYKWARDNVGQSGATIYRLYG
KPHAPELFLKHGKGSVANDVTDEMVRLNWLTEFMPLPTIKHFIRTPDDAWLLTTAIPGK
TAFQVLEEYPDSGENIVDALAVFLRRLHSIPVCNCPFNSDRVFRLAQAQSRMNNGLVDA
SDFDDERNGWPVEQVWKEMHNLLPFSPDSVVTHGDFSLDNLIFDEGKLIGCIDVGRVGI
ADRYQDLAILWNCLGEFSPSLQKRLFQKYGIDNPDMNKLQFHLMLDEFF"
Int complement(6522..7520)
/codon_start=1
/translation="MDAEAWLAGEKRLIEMETWTPPQDRAKKAAASAITLEEYTRKWLV
ERDLADGTRDLYSGHAERRIYPVLGEVAVTEMTPALVRAWWAGMGRKHPTARRHAYNVL
RAVMNTAVEDKLIAENPCRIEQKAADERDVEALTPEELDIVAAEIFVHYRIAAYILAWT
SLRFGELIELRRKDIVDDGMTMKLRVRRGASRVGNKIVVGNAKTVRSKRPVTVPPHVAE
MIRAHMKDRTKMNKGPEAFLVTTTQGNRLSKSAFTKSLKRGYAKIGRPELRIHDLRAVG
ATFAAQAGATTKELMARLGHTTPRMAMKYQMASEARDEAIAEAMSKLAKTS"
terminator 8170..8216
/note="大肠杆菌rrnB基因的转录终止子T1"
uvtetO promoter 8449..8625
tet operator 8626..8643
/gene="tetO"
/bound_moiety="tetracycline repressor TetR"
/note="tetR和tetA基因的细菌操作员O2"