Home >> Products & Services >> Plasmids in Stock

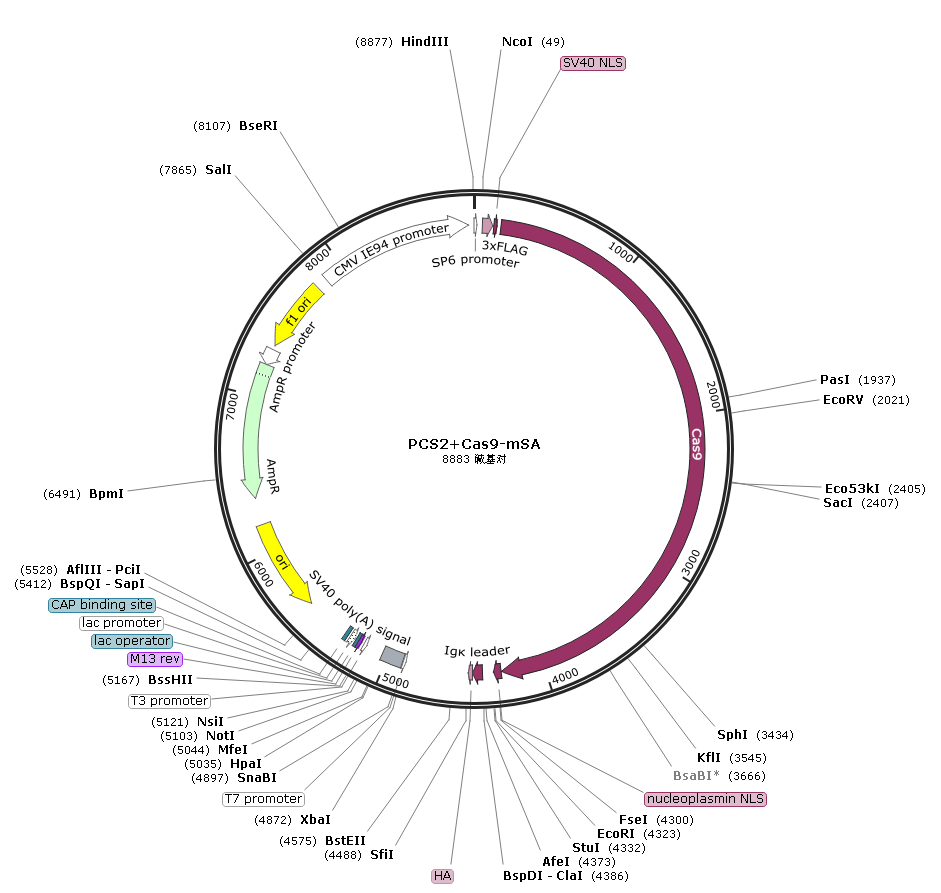
PCS2+Cas9-mSA

Catalog Number P5331
Alternative Names 等效质粒Plasmid#103882
Select Format
Quantity
Lead Time
In Stock
Price: Request a Quote
Contact us

Product Information

Plasmid NamePCS2+Cas9-mSAAlternative Names等效质粒Plasmid#103882
PromoterCMVRepliconpUC
Copy NumberhighCompetent CellStbl3
Culture Temp37°CBackbone VectorpCS2+
Forward PrimerCMV-F:Storage Temp37°C

Product Overview

Product Documents

Product Disclaimer

1.For Research Use Only

All products available through the MiaoLing Plasmid Platform are intended for research use only. They are not intended for clinical trials or for use in humans, including oral administration, injection, or therapeutic use in vivo or ex vivo.

2.Plasmid Sequence and Experimental Performance

Plasmid products are provided and sold based on the corresponding reference/template plasmid. MiaoLing guarantees the accuracy of the specified gene sequence based on our sequencing results, but does not guarantee downstream experimental performance, including gene expression, transfection efficiency, protein expression, or other experimental outcomes.

3.Sequence Verification of Certain Vector Products

For certain vector products, even the original manufacturer may not have fully verified the complete plasmid sequence. If the sequence of the key functional regions has been confirmed to be correct, the product will be considered a correct and usable vector for research purposes.

4.After-Sales Period for Small-Pack Plasmid Products

The after-sales service period for small-pack plasmid products is three months from the date of receipt. Customers are advised to transform and process the plasmid promptly after receipt. After the three-month period, a new purchase may be required for further support or replacement.

5.Research-Related Risks and Limitation of Liability

Scientific research is inherently exploratory and involves a significant degree of uncertainty. To the maximum extent permitted by applicable law, MiaoLing shall not be liable for any additional economic losses, indirect losses, or other liabilities arising from the use of our products or from research outcomes.

6.Citation in Chinese Publications

For publications in Chinese, please cite the product as follows:

7.Product Name (Product Item Number) was provided by the MiaoLing Plasmid Platform.

Citation in English Publications

For publications in English, please cite the product as follows:

“Product Name (Product Item Number) was obtained from MiaoLing Plasmid, China.”

Plasmid Sequence

ATTTAGGTGACACTATAGAATACAAGCTACTTGTTCTTTTTGCAGGATCCATGGACTATAAGGACCACGACGGAGACTACAAGGATCATGATATTGATTACAAAGACGATGACGATAAGATGGCCCCAAAGAAGAAGCGGAAGGTCGGTATCCACGGAGTCCCAGCAGCCGACAAGAAGTACAGCATCGGCCTGGACATCGGCACCAACTCTGTGGGCTGGGCCGTGATCACCGACGAGTACAAGGTGCCCAGCAAGAAATTCAAGGTGCTGGGCAACACCGACCGGCACAGCATCAAGAAGAACCTGATCGGAGCCCTGCTGTTCGACAGCGGCGAAACAGCCGAGGCCACCCGGCTGAAGAGAACCGCCAGAAGAAGATACACCAGACGGAAGAACCGGATCTGCTATCTGCAAGAGATCTTCAGCAACGAGATGGCCAAGGTGGACGACAGCTTCTTCCACAGACTGGAAGAGTCCTTCCTGGTGGAAGAGGATAAGAAGCACGAGCGGCACCCCATCTTCGGCAACATCGTGGACGAGGTGGCCTACCACGAGAAGTACCCCACCATCTACCACCTGAGAAAGAAACTGGTGGACAGCACCGACAAGGCCGACCTGCGGCTGATCTATCTGGCCCTGGCCCACATGATCAAGTTCCGGGGCCACTTCCTGATCGAGGGCGACCTGAACCCCGACAACAGCGACGTGGACAAGCTGTTCATCCAGCTGGTGCAGACCTACAACCAGCTGTTCGAGGAAAACCCCATCAACGCCAGCGGCGTGGACGCCAAGGCCATCCTGTCTGCCAGACTGAGCAAGAGCAGACGGCTGGAAAATCTGATCGCCCAGCTGCCCGGCGAGAAGAAGAATGGCCTGTTCGGAAACCTGATTGCCCTGAGCCTGGGCCTGACCCCCAACTTCAAGAGCAACTTCGACCTGGCCGAGGATGCCAAACTGCAGCTGAGCAAGGACACCTACGACGACGACCTGGACAACCTGCTGGCCCAGATCGGCGACCAGTACGCCGACCTGTTTCTGGCCGCCAAGAACCTGTCCGACGCCATCCTGCTGAGCGACATCCTGAGAGTGAACACCGAGATCACCAAGGCCCCCCTGAGCGCCTCTATGATCAAGAGATACGACGAGCACCACCAGGACCTGACCCTGCTGAAAGCTCTCGTGCGGCAGCAGCTGCCTGAGAAGTACAAAGAGATTTTCTTCGACCAGAGCAAGAACGGCTACGCCGGCTACATTGACGGCGGAGCCAGCCAGGAAGAGTTCTACAAGTTCATCAAGCCCATCCTGGAAAAGATGGACGGCACCGAGGAACTGCTCGTGAAGCTGAACAGAGAGGACCTGCTGCGGAAGCAGCGGACCTTCGACAACGGCAGCATCCCCCACCAGATCCACCTGGGAGAGCTGCACGCCATTCTGCGGCGGCAGGAAGATTTTTACCCATTCCTGAAGGACAACCGGGAAAAGATCGAGAAGATCCTGACCTTCCGCATCCCCTACTACGTGGGCCCTCTGGCCAGGGGAAACAGCAGATTCGCCTGGATGACCAGAAAGAGCGAGGAAACCATCACCCCCTGGAACTTCGAGGAAGTGGTGGACAAGGGCGCTTCCGCCCAGAGCTTCATCGAGCGGATGACCAACTTCGATAAGAACCTGCCCAACGAGAAGGTGCTGCCCAAGCACAGCCTGCTGTACGAGTACTTCACCGTGTATAACGAGCTGACCAAAGTGAAATACGTGACCGAGGGAATGAGAAAGCCCGCCTTCCTGAGCGGCGAGCAGAAAAAGGCCATCGTGGACCTGCTGTTCAAGACCAACCGGAAAGTGACCGTGAAGCAGCTGAAAGAGGACTACTTCAAGAAAATCGAGTGCTTCGACTCCGTGGAAATCTCCGGCGTGGAAGATCGGTTCAACGCCTCCCTGGGCACATACCACGATCTGCTGAAAATTATCAAGGACAAGGACTTCCTGGACAATGAGGAAAACGAGGACATTCTGGAAGATATCGTGCTGACCCTGACACTGTTTGAGGACAGAGAGATGATCGAGGAACGGCTGAAAACCTATGCCCACCTGTTCGACGACAAAGTGATGAAGCAGCTGAAGCGGCGGAGATACACCGGCTGGGGCAGGCTGAGCCGGAAGCTGATCAACGGCATCCGGGACAAGCAGTCCGGCAAGACAATCCTGGATTTCCTGAAGTCCGACGGCTTCGCCAACAGAAACTTCATGCAGCTGATCCACGACGACAGCCTGACCTTTAAAGAGGACATCCAGAAAGCCCAGGTGTCCGGCCAGGGCGATAGCCTGCACGAGCACATTGCCAATCTGGCCGGCAGCCCCGCCATTAAGAAGGGCATCCTGCAGACAGTGAAGGTGGTGGACGAGCTCGTGAAAGTGATGGGCCGGCACAAGCCCGAGAACATCGTGATCGAAATGGCCAGAGAGAACCAGACCACCCAGAAGGGACAGAAGAACAGCCGCGAGAGAATGAAGCGGATCGAAGAGGGCATCAAAGAGCTGGGCAGCCAGATCCTGAAAGAACACCCCGTGGAAAACACCCAGCTGCAGAACGAGAAGCTGTACCTGTACTACCTGCAGAATGGGCGGGATATGTACGTGGACCAGGAACTGGACATCAACCGGCTGTCCGACTACGATGTGGACCATATCGTGCCTCAGAGCTTTCTGAAGGACGACTCCATCGACAACAAGGTGCTGACCAGAAGCGACAAGAACCGGGGCAAGAGCGACAACGTGCCCTCCGAAGAGGTCGTGAAGAAGATGAAGAACTACTGGCGGCAGCTGCTGAACGCCAAGCTGATTACCCAGAGAAAGTTCGACAATCTGACCAAGGCCGAGAGAGGCGGCCTGAGCGAACTGGATAAGGCCGGCTTCATCAAGAGACAGCTGGTGGAAACCCGGCAGATCACAAAGCACGTGGCACAGATCCTGGACTCCCGGATGAACACTAAGTACGACGAGAATGACAAGCTGATCCGGGAAGTGAAAGTGATCACCCTGAAGTCCAAGCTGGTGTCCGATTTCCGGAAGGATTTCCAGTTTTACAAAGTGCGCGAGATCAACAACTACCACCACGCCCACGACGCCTACCTGAACGCCGTCGTGGGAACCGCCCTGATCAAAAAGTACCCTAAGCTGGAAAGCGAGTTCGTGTACGGCGACTACAAGGTGTACGACGTGCGGAAGATGATCGCCAAGAGCGAGCAGGAAATCGGCAAGGCTACCGCCAAGTACTTCTTCTACAGCAACATCATGAACTTTTTCAAGACCGAGATTACCCTGGCCAACGGCGAGATCCGGAAGCGGCCTCTGATCGAGACAAACGGCGAAACCGGGGAGATCGTGTGGGATAAGGGCCGGGATTTTGCCACCGTGCGGAAAGTGCTGAGCATGCCCCAAGTGAATATCGTGAAAAAGACCGAGGTGCAGACAGGCGGCTTCAGCAAAGAGTCTATCCTGCCCAAGAGGAACAGCGATAAGCTGATCGCCAGAAAGAAGGACTGGGACCCTAAGAAGTACGGCGGCTTCGACAGCCCCACCGTGGCCTATTCTGTGCTGGTGGTGGCCAAAGTGGAAAAGGGCAAGTCCAAGAAACTGAAGAGTGTGAAAGAGCTGCTGGGGATCACCATCATGGAAAGAAGCAGCTTCGAGAAGAATCCCATCGACTTTCTGGAAGCCAAGGGCTACAAAGAAGTGAAAAAGGACCTGATCATCAAGCTGCCTAAGTACTCCCTGTTCGAGCTGGAAAACGGCCGGAAGAGAATGCTGGCCTCTGCCGGCGAACTGCAGAAGGGAAACGAACTGGCCCTGCCCTCCAAATATGTGAACTTCCTGTACCTGGCCAGCCACTATGAGAAGCTGAAGGGCTCCCCCGAGGATAATGAGCAGAAACAGCTGTTTGTGGAACAGCACAAGCACTACCTGGACGAGATCATCGAGCAGATCAGCGAGTTCTCCAAGAGAGTGATCCTGGCCGACGCTAATCTGGACAAAGTGCTGTCCGCCTACAACAAGCACCGGGATAAGCCCATCAGAGAGCAGGCCGAGAATATCATCCACCTGTTTACCCTGACCAATCTGGGAGCCCCTGCCGCCTTCAAGTACTTTGACACCACCATCGACCGGAAGAGGTACACCAGCACCAAAGAGGTGCTGGACGCCACCCTGATCCACCAGAGCATCACCGGCCTGTACGAGACACGGATCGACCTGTCTCAGCTGGGAGGCGACAAAAGGCCGGCGGCCACGAAAAAGGCCGGCCAGGCAAAAAAGAAAAAGTATGAATTCAAGGCCTCTCGAAGCGGTTCAGAGACCCCAGGAACTAGCGAGAGCGCTACACCGGAATCGATGGAGACAGACACACTCCTGCTATGGGTACTGCTGCTCTGGGTTCCAGGTTCCACTGGTGACTATCCATATGATGTTCCAGATTATGCTGGGGCCCAGCCGGCCAGATCTATGGCGGAAGCGGGTATCACCGGCACGTGGTACAACCAGTCTGGTTCTACCTTCACCGTTACCGCGGGTGCGGACGGTAACCTGACCGGTCAGTACGAAAACCGTGCGCAGGGCACTGGTTGCCAGAACTCTCCGTACACCCTGACCGGTCGTTACAACGGTACCAAACTGGAATGGCGTGTTGAATGGAACAACTCTACCGAAAACTGCCACTCTCGTACCGAATGGCGTGGTCAGTACCAGGGTGGTGCGGAAGCGCGTATCAACACCCAGTGGAACCTGACCTACGAAGGTGGTTCTGGTCCGGCGACCGAACAGGGTCAGGACACCTTCACCAAAGTTAAACCGTCTGCGGCGTCTGGATCCTGAGCCTCTAGAACTATAGTGAGTCGTATTACGTAGATCCAGACATGATAAGATACATTGATGAGTTTGGACAAACCACAACTAGAATGCAGTGAAAAAAATGCTTTATTTGTGAAATTTGTGATGCTATTGCTTTATTTGTAACCATTATAAGCTGCAATAAACAAGTTAACAACAACAATTGCATTCATTTTATGTTTCAGGTTCAGGGGGAGGTGTGGGAGGTTTTTTAATTCGCGGCCGCGGCGCCAATGCATTGGGCCCGGTACCCAGCTTTTGTTCCCTTTAGTGAGGGTTAATTGCGCGCTTGGCGTAATCATGGTCATAGCTGTTTCCTGTGTGAAATTGTTATCCGCTCACAATTCCACACAACATACGAGCCGGGAGCATAAAGTGTAAAGCCTGGGGTGCCTAATGAGTGAGCTAACTCACATTAATTGCGTTGCGCTCACTGCCCGCTTTCCAGTCGGGAAACCTGTCGTGCCAGCTGCATTAATGAATCGGCCAACGCGCGGGGAGAGGCGGTTTGCGTATTGGGCGCTCTTCCGCTTCCTCGCTCACTGACTCGCTGCGCTCGGTCGTTCGGCTGCGGCGAGCGGTATCAGCTCACTCAAAGGCGGTAATACGGTTATCCACAGAATCAGGGGATAACGCAGGAAAGAACATGTGAGCAAAAGGCCAGCAAAAGGCCAGGAACCGTAAAAAGGCCGCGTTGCTGGCGTTTTTCCATAGGCTCCGCCCCCCTGACGAGCATCACAAAAATCGACGCTCAAGTCAGAGGTGGCGAAACCCGACAGGACTATAAAGATACCAGGCGTTTCCCCCTGGAAGCTCCCTCGTGCGCTCTCCTGTTCCGACCCTGCCGCTTACCGGATACCTGTCCGCCTTTCTCCCTTCGGGAAGCGTGGCGCTTTCTCATAGCTCACGCTGTAGGTATCTCAGTTCGGTGTAGGTCGTTCGCTCCAAGCTGGGCTGTGTGCACGAACCCCCCGTTCAGCCCGACCGCTGCGCCTTATCCGGTAACTATCGTCTTGAGTCCAACCCGGTAAGACACGACTTATCGCCACTGGCAGCAGCCACTGGTAACAGGATTAGCAGAGCGAGGTATGTAGGCGGTGCTACAGAGTTCTTGAAGTGGTGGCCTAACTACGGCTACACTAGAAGAACAGTATTTGGTATCTGCGCTCTGCTGAAGCCAGTTACCTTCGGAAAAAGAGTTGGTAGCTCTTGATCCGGCAAACAAACCACCGCTGGTAGCGGTGGTTTTTTTGTTTGCAAGCAGCAGATTACGCGCAGAAAAAAAGGATCTCAAGAAGATCCTTTGATCTTTTCTACGGGGTCTGACGCTCAGTGGAACGAAAACTCACGTTAAGGGATTTTGGTCATGAGATTATCAAAAAGGATCTTCACCTAGATCCTTTTAAATTAAAAATGAAGTTTTAAATCAATCTAAAGTATATATGAGTAAACTTGGTCTGACAGTTACCAATGCTTAATCAGTGAGGCACCTATCTCAGCGATCTGTCTATTTCGTTCATCCATAGTTGCCTGACTCCCCGTCGTGTAGATAACTACGATACGGGAGGGCTTACCATCTGGCCCCAGTGCTGCAATGATACCGCGAGACCCACGCTCACCGGCTCCAGATTTATCAGCAATAAACCAGCCAGCCGGAAGGGCCGAGCGCAGAAGTGGTCCTGCAACTTTATCCGCCTCCATCCAGTCTATTAATTGTTGCCGGGAAGCTAGAGTAAGTAGTTCGCCAGTTAATAGTTTGCGCAACGTTGTTGCCATTGCTACAGGCATCGTGGTGTCACGCTCGTCGTTTGGTATGGCTTCATTCAGCTCCGGTTCCCAACGATCAAGGCGAGTTACATGATCCCCCATGTTGTGCAAAAAAGCGGTTAGCTCCTTCGGTCCTCCGATCGTTGTCAGAAGTAAGTTGGCCGCAGTGTTATCACTCATGGTTATGGCAGCACTGCATAATTCTCTTACTGTCATGCCATCCGTAAGATGCTTTTCTGTGACTGGTGAGTACTCAACCAAGTCATTCTGAGAATAGTGTATGCGGCGACCGAGTTGCTCTTGCCCGGCGTCAATACGGGATAATACCGCGCCACATAGCAGAACTTTAAAAGTGCTCATCATTGGAAAACGTTCTTCGGGGCGAAAACTCTCAAGGATCTTACCGCTGTTGAGATCCAGTTCGATGTAACCCACTCGTGCACCCAACTGATCTTCAGCATCTTTTACTTTCACCAGCGTTTCTGGGTGAGCAAAAACAGGAAGGCAAAATGCCGCAAAAAAGGGAATAAGGGCGACACGGAAATGTTGAATACTCATACTCTTCCTTTTTCAATATTATTGAAGCATTTATCAGGGTTATTGTCTCATGAGCGGATACATATTTGAATGTATTTAGAAAAATAAACAAATAGGGGTTCCGCGCACATTTCCCCGAAAAGTGCCACCTAAATTGTAAGCGTTAATATTTTGTTAAAATTCGCGTTAAATTTTTGTTAAATCAGCTCATTTTTTAACCAATAGGCCGAAATCGGCAAAATCCCTTATAAATCAAAAGAATAGACCGAGATAGGGTTGAGTGTTGTTCCAGTTTGGAACAAGAGTCCACTATTAAAGAACGTGGACTCCAACGTCAAAGGGCGAAAAACCGTCTATCAGGGCGATGGCCCACTACGTGAACCATCACCCTAATCAAGTTTTTTGGGGTCGAGGTGCCGTAAAGCACTAAATCGGAACCCTAAAGGGAGCCCCCGATTTAGAGCTTGACGGGGAAAGCCGGCGAACGTGGCGAGAAAGGAAGGGAAGAAAGCGAAAGGAGCGGGCGCTAGGGCGCTGGCAAGTGTAGCGGTCACGCTGCGCGTAACCACCACACCCGCCGCGCTTAATGCGCCGCTACAGGGCGCGTCCCATTCGCCATTCAGGCTGCGCAACTGTTGGGAAGGGCGATCGGTGCGGGCCTCTTCGCTATTACGCCAGTCGACCGCCAATTCAATATGGCGTATATGGACTCATGCCAATTCAATATGGTGGATCTGGACCTGTGCCAATTCAATATGGCGTATATGGACTCGTGCCAATTCAATATGGTGGATCTGGACCCCAGCCAATTCAATATGGCGGACTTGGCACCATGCCAATTCAATATGGCGGACCTGGCACTGTGCCAACTGGGGAGGGGTCTACTTGGCACGGTGCCAAGTTTGAGGAGGGGTCTTGGCCCTGTGCCAAGTCCGCCATATTGAATTGGCATGGTGCCAATAATGGCGGCCATATTGGCTATATGCCAGGATCAATATATAGGCAATATCCAATATGGCCCTATGCCAATATGGCTATTGGCCAGGTTCAATACTATGTATTGGCCCTATGCCATATAGTATTCCATATATGGGTTTTCCTATTGACGTAGATAGCCCCTCCCAATGGGCGGTCCCATATACCATATATGGGGCTTCCTAATACCGCCCATAGCCACTCCCCCATTGACGTCAATGGTCTCTATATATGGTCTTTCCTATTGACGTCATATGGGCGGTCCTATTGACGTATATGGCGCCTCCCCCATTGACGTCAATTACGGTAAATGGCCCGCCTGGCTCAATGCCCATTGACGTCAATAGGACCACCCACCATTGACGTCAATGGGATGGCTCATTGCCCATTCATATCCGTTCTCACGCCCCCTATTGACGTCAATGACGGTAAATGGCCCACTTGGCAGTACATCAATATCTATTAATAGTAACTTGGCAAGTACATTACTATTGGAAGTACGCCAGGGTACATTGGCAGTACTCCCATTGACGTCAATGGCGGTAAATGGCCCGCGATGGCTGCCAAGTACATCCCCATTGACGTCAATGGGGAGGGGCAATGACGCAAATGGGCGTTCCATTGACGTAAATGGGCGGTAGGCGTGCCTAATGGGAGGTCTATATAAGCAATGCTCGTTTAGGGAACCGCCATTCTGCCTGGGGACGTCGGAGCAAGCTTG

Related Publications

No Literature Available

Plasmid Elements

SP6 promoter        1..19
                     /note="噬菌体SP6 RNA聚合酶启动子"
     CDS             54..119
                     /codon_start=1
                     /product="three tandem FLAG(R) epitope tags, followed by an
                     enterokinase cleavage site"
                     Cleavage site after base 119"
                     /translation="DYKDHDGDYKDHDIDYKDDDDK"
     SV40 NLS             126..146
                     /codon_start=1
                     /product="nuclear localization signal of SV40 (simian virus
                     40) large T antigen"
                     /translation="PKKKRKV"
     CDS             171..4271
                     /codon_start=1
                     /product="Cas9 (Csn1) endonuclease from the Streptococcus 
                     pyogenes Type II CRISPR/Cas system"
                     /note="在DNA中产生RNA引导的双链断裂"
                     /translation="DKKYSIGLDIGTNSVGWAVITDEYKVPSKKFKVLGNTDRHSIKKN
                     LIGALLFDSGETAEATRLKRTARRRYTRRKNRICYLQEIFSNEMAKVDDSFFHRLEESF
                     LVEEDKKHERHPIFGNIVDEVAYHEKYPTIYHLRKKLVDSTDKADLRLIYLALAHMIKF
                     RGHFLIEGDLNPDNSDVDKLFIQLVQTYNQLFEENPINASGVDAKAILSARLSKSRRLE
                     NLIAQLPGEKKNGLFGNLIALSLGLTPNFKSNFDLAEDAKLQLSKDTYDDDLDNLLAQI
                     GDQYADLFLAAKNLSDAILLSDILRVNTEITKAPLSASMIKRYDEHHQDLTLLKALVRQ
                     QLPEKYKEIFFDQSKNGYAGYIDGGASQEEFYKFIKPILEKMDGTEELLVKLNREDLLR
                     KQRTFDNGSIPHQIHLGELHAILRRQEDFYPFLKDNREKIEKILTFRIPYYVGPLARGN
                     SRFAWMTRKSEETITPWNFEEVVDKGASAQSFIERMTNFDKNLPNEKVLPKHSLLYEYF
                     TVYNELTKVKYVTEGMRKPAFLSGEQKKAIVDLLFKTNRKVTVKQLKEDYFKKIECFDS
                     VEISGVEDRFNASLGTYHDLLKIIKDKDFLDNEENEDILEDIVLTLTLFEDREMIEERL
                     KTYAHLFDDKVMKQLKRRRYTGWGRLSRKLINGIRDKQSGKTILDFLKSDGFANRNFMQ
                     LIHDDSLTFKEDIQKAQVSGQGDSLHEHIANLAGSPAIKKGILQTVKVVDELVKVMGRH
                     KPENIVIEMARENQTTQKGQKNSRERMKRIEEGIKELGSQILKEHPVENTQLQNEKLYL
                     YYLQNGRDMYVDQELDINRLSDYDVDHIVPQSFLKDDSIDNKVLTRSDKNRGKSDNVPS
                     EEVVKKMKNYWRQLLNAKLITQRKFDNLTKAERGGLSELDKAGFIKRQLVETRQITKHV
                     AQILDSRMNTKYDENDKLIREVKVITLKSKLVSDFRKDFQFYKVREINNYHHAHDAYLN
                     AVVGTALIKKYPKLESEFVYGDYKVYDVRKMIAKSEQEIGKATAKYFFYSNIMNFFKTE
                     ITLANGEIRKRPLIETNGETGEIVWDKGRDFATVRKVLSMPQVNIVKKTEVQTGGFSKE
                     SILPKRNSDKLIARKKDWDPKKYGGFDSPTVAYSVLVVAKVEKGKSKKLKSVKELLGIT
                     IMERSSFEKNPIDFLEAKGYKEVKKDLIIKLPKYSLFELENGRKRMLASAGELQKGNEL
                     ALPSKYVNFLYLASHYEKLKGSPEDNEQKQLFVEQHKHYLDEIIEQISEFSKRVILADA
                     NLDKVLSAYNKHRDKPIREQAENIIHLFTLTNLGAPAAFKYFDTTIDRKRYTSTKEVLD
                     ATLIHQSITGLYETRIDLSQLGGD"
     nucleoplasmin NLS             4272..4319
                     /codon_start=1
                     /product="bipartite nuclear localization signal from 
                     nucleoplasmin"
                     /translation="KRPAATKKAGQAKKKK"
     sig_peptide     4389..4451
                     /product="leader sequence from mouse immunoglobulin kappa 
                     light chain"
                     Cleavage site after base 4448"
     HA             4452..4478
                     /codon_start=1
                     /product="HA (human influenza hemagglutinin) epitope tag"
                     /translation="YPYDVPDYA"
     T7 promoter        complement(4878..4896)
                     /note="噬菌体T7 RNA聚合酶启动子"
     SV40 poly(A) signal    4901..5035
                     /note="SV40聚腺苷酸化信号"
     T3 promoter        complement(5148..5166)
                     /note="噬菌体T3 RNA聚合酶启动子"
     primer_bind     complement(5187..5203)
                     /note="常见的测序引物,多种相似变体之一"
     lac operator    5211..5227
                     /bound_moiety="lac repressor encoded by lacI"
                     /note="lac阻遏物与lac操作员结合,抑制大肠杆菌中的转录。这种抑制可以通过添加乳糖或异丙基β-D-硫代吡喃半乳糖苷(IPTG)来缓解。"
     lac promoter        complement(5235..5265)
                     /note="大肠杆菌lac操纵子的启动子"
     CAP binding site    5280..5301
                     /bound_moiety="E. coli catabolite activator protein"
                     /note="CAP结合在cAMP存在下激活转录。"
     ori      complement(5589..6177)
                     /direction=LEFT
                     /note="高拷贝数ColE1/pMB1/pBR322/pUC复制起点"
     AmpR             complement(6348..7208)
                     /codon_start=1
                     /gene="bla"
                     /product="beta-lactamase"
                     /note="对氨苄青霉素、羧苄青霉素和相关抗生素产生耐药性"
                     /translation="MSIQHFRVALIPFFAAFCLPVFAHPETLVKVKDAEDQLGARVGYI
                     ELDLNSGKILESFRPEERFPMMSTFKVLLCGAVLSRIDAGQEQLGRRIHYSQNDLVEYS
                     PVTEKHLTDGMTVRELCSAAITMSDNTAANLLLTTIGGPKELTAFLHNMGDHVTRLDRW
                     EPELNEAIPNDERDTTMPVAMATTLRKLLTGELLTLASRQQLIDWMEADKVAGPLLRSA
                     LPAGWFIADKSGAGERGSRGIIAALGPDGKPSRIVVIYTTGSQATMDERNRQIAEIGAS
                     LIKHW"
     AmpR promoter        complement(7209..7313)
                     /gene="bla"
     f1 ori      complement(7339..7794)
                     /direction=LEFT
                     /note="f1噬菌体复制起点;箭头表示(+)链合成的方向"
     CMV IE94 promoter        7872..8849
                     /note="猿猴巨细胞病毒主要即刻早期转录单位IE94的增强子/启动子区"
×

Plasmid Sequence

×
(Some plasmids are not full-length sequences)